
Haz la pregunta que cualquier administrador ha querido plantearle alguna vez a una consola de gestión: «¿Qué dejará de funcionar si cambio esto?». Y obtén la respuesta antes de aplicar nada.
Durante quince años, el sector de la gestión de endpoints ha estado perfeccionando lo que no debía.
Hemos creado mejores consolas. Mejores filtros. Mejores informes, mejores exportaciones y mejores paneles que revisar el lunes por la mañana. Todo parte de una suposición que nadie ha cuestionado: que en algún lugar hay una persona con tiempo para entrar y mirar.
No la hay. Hace años que no la hay. Demasiadas herramientas, demasiadas políticas y una gestión de IT demasiado reactiva. Una flota de cierto tamaño genera cada mañana más preguntas de las que cualquier equipo puede plantear. La mayoría nunca llegan a hacerse y la distancia entre lo que dicen tus políticas y lo que hacen realmente tus dispositivos aumenta en silencio hasta que algo te obliga a revisarla.
Applivery Intelligence elimina esa distancia al sacar a la persona de la tarea de buscar y mantenerla justo donde debe estar: en la toma de decisiones. Intelligence closes that gap by removing the person from the looking and keeping them exactly where they belong: on the deciding.
Qué es la gestión autónoma de endpoints
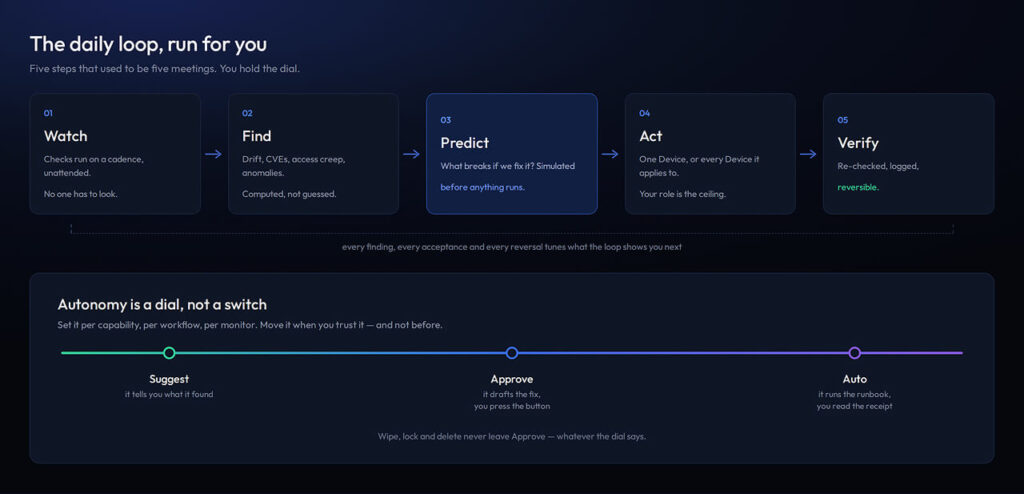
La gestión autónoma de endpoints (Autonomous Endpoint Management o AEM) no es una consola con un chat. Es un modelo operativo compuesto por cinco pasos, y Applivery Intelligence ejecuta los cinco:
- Supervisar: las comprobaciones se ejecutan continuamente, con una frecuencia definida y sin intervención.
- Detectar: identifica desviaciones, exposiciones, acumulación de accesos y anomalías a partir de cálculos, no de suposiciones.
- Predecir: simula qué efecto tendría una corrección antes de modificar cualquier dispositivo.
- Actuar: interviene sobre un dispositivo o sobre todos los dispositivos a los que corresponda, de acuerdo con tu rol y tus aprobaciones.
- Verificar: vuelve a comprobar el resultado, registra lo ocurrido en cada dispositivo y permite revertirlo.
Después, el ciclo vuelve a empezar con mayor precisión: cada hallazgo que aceptas, descartas o reviertes ajusta lo que el sistema te mostrará a continuación.
El ciclo funciona sin ti y se detiene exactamente donde le hayas indicado. Pero un ciclo en el que nadie puede intervenir es una caja negra. Por eso, antes de explicar los cinco pasos, hay que hablar del lugar desde el que puedes entrar en él.
Chat: el espacio desde el que funciona todo el ciclo
La autonomía no elimina a la persona. Cambia a qué dedica su jornada y necesita un lugar desde el que pueda incorporarse al ciclo en cualquier momento. Ese lugar es Chat. Es la pieza central de todo lo que viene después, no una interfaz añadida al margen.
Así transcurre una tarde de trabajo real:
- Haces una pregunta porque quieres entender algo: ¿A qué dispositivos llegó realmente el despliegue de macOS 14? La respuesta llega en forma de artefacto: una tabla de dispositivos que puedes ordenar, una comparación de políticas, un mapa, un desglose de CVE o el registro de una acción con su historial de aprobaciones.
- Lo fijas. Ese artefacto se convierte en un widget activo dentro de un panel de Insights y comienza a actualizarse por sí solo. La pregunta que hiciste una vez pasa a ser un dato que se supervisa automáticamente.
- Configuras una alerta, y esa alerta inicia un Workflow. Aquello sobre lo que preguntaste se convierte en algo sobre lo que la plataforma puede actuar.
- Cowork encuentra el siguiente problema antes que tú. Si quieres debatir un hallazgo, puedes abrir un chat lateral con el especialista que lo detectó, que conserva todas las evidencias.
- Haces la siguiente pregunta, que normalmente surge del propio hallazgo.
Se accede a cada espacio descrito en esta publicación desde una conversación y se vuelve a ella. Chat es donde empieza el trabajo, donde lo examinas y donde entiendes lo que ocurrió después. Los paneles, los procedimientos y los hallazgos son donde ese trabajo permanece entre una conversación y otra.
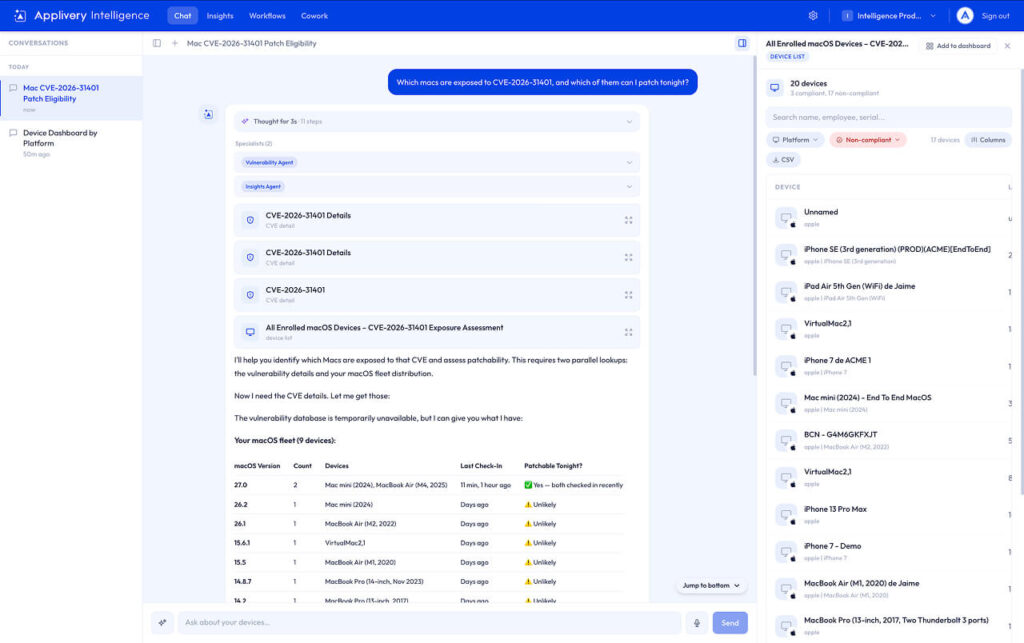
Hay dos características que convierten Chat en un espacio de control y no en una simple ventana de conversación. Sus respuestas están basadas en datos reales: cualquier respuesta que contenga datos procede de un especialista que ha tenido que consultarlos. Si el Workspace no ofrece ninguna capacidad, el asistente se niega a responder en lugar de inventar una flota que parezca creíble. También permite actuar: desde la misma conversación que respondió a la pregunta puedes ejecutar una acción con tus permisos y previa confirmación.
Además, se encuentra dentro del Dashboard de Applivery, en el Workspace que ya tienes abierto y reutilizando tu sesión. No hay una segunda consola, otro inicio de sesión ni nada que instalar. Un producto de IA separado es otro lugar al que tienes que acordarte de entrar, lo que reproduce el mismo hábito reactivo. Un asistente integrado en el producto que ya utilizas es un asistente que realmente utilizas.
Supervisar: la flota informa de lo que ocurre
Insights suele ser el primer espacio que conocen los usuarios y normalmente se describe como un conjunto de «paneles». Esa descripción se queda corta en dos aspectos.
Visibilidad con el nivel de detalle que necesites. Haz una pregunta, recibe la respuesta y pulsa Add to dashboard. La respuesta se convierte en un widget activo que vuelve a ejecutar la consulta automáticamente. Puede mostrarse como indicador KPI, gráfico de líneas, barras o anillos, tabla, mapa o tarjeta. Un dispositivo, un segmento, un país o todos tus dispositivos: el nivel de detalle depende de la pregunta. Los paneles se actualizan mediante una expresión cron real y son compatibles con todas las zonas horarias. El encabezado muestra cuándo se ejecutó la última actualización, cuándo se producirá la siguiente y te avisa si alguna se retrasa, en lugar de mostrar datos desactualizados sin advertirlo.
Y capacidad de actuación, que es la parte que realmente importa. Un widget no es solo una imagen. Puede incluir reglas de alerta por superar un umbral, registrar un cambio superior al N % o detectar la ausencia de actualizaciones durante un periodo determinado. También permite configurar el modo de notificación y un tiempo de espera para que recibas un aviso, no sesenta. Una alerta tampoco tiene que terminar en una notificación: puede iniciar un Workflow, de modo que el proceso que va desde el dato cambia hasta se hace algo al respecto se completa sin una persona de por medio.
Esa es la diferencia entre un panel y una capa operativa. Un panel te dice que ha aumentado la brecha de cifrado. Esta capa te avisa, abre la corrección y, si así lo has configurado, la resuelve antes de que hayas leído el mensaje.

Detectar: las dos cosas que nadie tiene tiempo de buscar
Pregunta a cualquier equipo de IT qué debería revisar cada semana y no revisa. Las respuestas suelen ser las mismas.
Vulnerabilidades conocidas. Vulnerability Agent compara la información publicada con lo que realmente ejecutan tus dispositivos: gravedad, presencia en el catálogo Known Exploited Vulnerabilities y probabilidad de explotación, junto a los dispositivos de tu flota que utilizan la versión afectada. Fija el resultado y la pregunta «¿Cuál es nuestra exposición ahora mismo?» deja de ser una investigación que alguien inicia después de un incidente para convertirse en un dato que se actualiza automáticamente.
Desviaciones de configuración. La distancia entre la política que diseñaste y la configuración que finalmente recibió un dispositivo es donde se encuentra gran parte de la exposición real. Esa distancia no aparece en una lista de políticas. Intelligence la aborda desde tres frentes: comprobaciones que detectan conflictos de composición, políticas cuya composición no produce ningún resultado, carencias de seguridad en el modo kiosco y secretos incluidos en una configuración aplicada; Policy Agent, que compara políticas y ajusta sus prioridades; e Impact Agent, que indica qué dejaría de funcionar antes de aplicar un cambio.
A esto se suma el resto del catálogo: dispositivos que llevan demasiado tiempo sin conectarse, sistemas operativos obsoletos, permisos demasiado amplios, cuentas con privilegios sin autenticación de doble factor, administradores inactivos, números de serie duplicados, activos vinculados a dispositivos que ya no existen y picos de inscripción o uso de datos comparados con el historial de cada dispositivo. El resultado no es una lista de alertas. Es la auditoría que nunca tienes tiempo de hacer, ejecutándose continuamente.
Predecir: conoce la respuesta antes de pulsar el botón
Esta es la capacidad que el sector nunca ha tenido y por la que te pedimos que nos valores.
Todo administrador con experiencia tiene la misma cicatriz: un cambio de política que parecía obviamente correcto, aplicado un viernes, y que el sábado por la mañana dejó bloqueado a todo un turno de dispositivos en modo kiosco. La razón siempre es la misma: la configuración efectiva se compone, no se escribe. Lo que recibe un dispositivo es el resultado de todo lo que se dirige a él, y ninguna vista en forma de lista ha mostrado nunca ese resultado antes de aplicarlo.
Applivery Intelligence responde a la pregunta con antelación:
Si aumento la prioridad de la política Baseline Security, ¿qué dispositivos cambiarán y qué perderán?
Impact Agent responde en modo de solo lectura sobre una composición simulada. Muestra el antes y el después de cada dispositivo sin modificar nada. Los cambios en audiencias y segmentos pueden previsualizarse de la misma forma: quién se vería afectado, calculado sobre la población real, antes de guardar la regla. Cuando se propone una corrección, los dispositivos afectados vuelven a comprobarse en el momento de la ejecución para garantizar que se ejecute exactamente lo que aprobaste.
La predicción también funciona hacia delante y en paralelo. Las comprobaciones de anomalías comparan cada dispositivo con su propio historial, de modo que un pico representa un cambio de comportamiento y no simplemente un dispositivo con mucha actividad. Los sistemas operativos obsoletos y la exposición a vulnerabilidades CVE aparecen cuando todavía pueden resolverse durante una ventana de mantenimiento, en lugar de hacerlo después de una brecha. Las desviaciones de acceso se detectan cuando todavía son un permiso que alguien olvidó retirar. El incidente más barato es el que se detectó como hallazgo tres semanas antes.
Actuar: de forma quirúrgica o en toda la flota
Detectar sin actuar es una forma más agradable de preocuparse. Applivery Intelligence actúa en ambos extremos de la escala con las mismas garantías.
De forma quirúrgica. Escribe @ para hacer referencia a un único objeto: un dispositivo, una política, un usuario MDM, un segmento, una audiencia de dispositivos, una regla de automatización o una plantilla de inscripción. Después, actúa exactamente sobre ese objeto. Bloquea el portátil que David perdió ayer. La referencia incluye la identidad del objeto, por lo que el sistema no tiene que adivinar a qué «MacBook Pro» te referías.
En toda la flota. Las mismas acciones pueden ejecutarse sobre una población completa. Una corrección actúa sobre todos los elementos de un hallazgo que hayan superado la nueva comprobación, y un nodo for-each de un Workflow ejecuta un paso en cada dispositivo de una lista calculada, con reintentos y espera progresiva. La seguridad no depende de la cautela, sino de la estructura: la población se calcula y nunca la describe un modelo; cualquier acción irreversible tiene delante una puerta de aprobación; la ejecución se registra por dispositivo; y Revert deshace únicamente los pasos que se completaron correctamente.
Un dispositivo sin abrir cinco pantallas. Cuatro mil dispositivos sin escribir un script. En ambos casos queda un registro de auditoría.

Verificar: registros, no promesasVerificar: registros, no promesas
Cada acción genera un registro: qué se ejecutó, en qué dispositivo, con qué parámetros, bajo el nombre de quién y con qué resultado. Las ejecuciones de Workflows conservan la entrada y la salida de cada nodo. Cowork vuelve a calcular los datos después de la ejecución para confirmar que el hallazgo se ha resuelto realmente. El propio registro de auditoría de Applivery guarda toda esta información bajo la identidad de la persona que aprobó la acción, no bajo una cuenta de servicio, porque no existe ninguna.
Esta es la parte menos llamativa de la autonomía, pero también la que determina si una organización regulada puede adoptarla.
Cowork: el compañero que trabaja sobre tu flota cuando tú no estás
Cowork es el punto en el que todo esto deja de ser algo que tú utilizas y pasa a trabajar por ti.
Los agentes especialistas se ejecutan en segundo plano con la frecuencia que hayas establecido. Examinan la flota y generan hallazgos: elementos de una bandeja de entrada que incluyen las evidencias, identifican los dispositivos afectados y, cuando la comprobación lo permite, incorporan una corrección ya preparada. Puedes marcarlos como revisados, aceptarlos, debatirlos en un chat lateral con el agente que los detectó o aprobar la corrección y observar cómo se ejecuta.
Tres propiedades hacen que funcione como un compañero y no como un riesgo:
- Está supervisado por diseño. La detección depende de código determinista desarrollado por Applivery, no de un modelo que decide qué parece incorrecto. Las correcciones son plantillas con control de versiones, no planes improvisados por un modelo. El agente clasifica y explica, pero no puede inventar un objetivo ni una acción.
- Sabe cuándo no ha funcionado. Cowork diferencia entre «la comprobación se ejecutó y no encontró nada» y «la comprobación no pudo ejecutarse». El estado verde Nothing to review solo aparece cuando existen pruebas de que la flota se examinó realmente, porque un sistema de supervisión que deja de informar cuando falla es peor que no tener ninguno.
- Mejora con tu flota. Cada aceptación, descarte, cambio de umbral o reversión aporta información: los hallazgos aceptados dejan de preguntar, los monitores restringen su alcance y gravedad a lo que realmente te interesa y Applivery añade nuevas comprobaciones al mismo catálogo a medida que aparecen nuevas clases de problemas. El ciclo que utilizas durante el tercer mes no es el mismo con el que empezaste.

La constelación
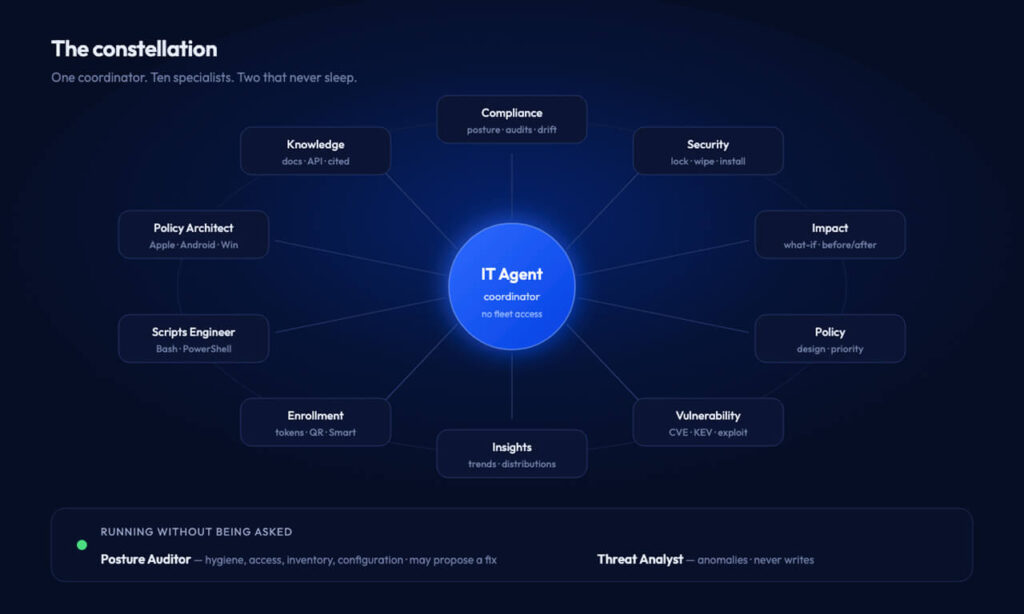
Nada de esto depende de un único modelo que lo hace todo. Esa arquitectura no se puede gobernar ni escalar. Un coordinador, IT Agent, lee cada petición y la dirige a uno o varios Agentic Specialists, cada uno con su propia función, sus propias instrucciones y un conjunto restringido de capacidades de la plataforma. El coordinador no tiene acceso directo a tus dispositivos: todas las respuestas que contienen datos proceden de un especialista que ha tenido que consultarlos.
| Especialista | Responsabilidad |
|---|---|
| Compliance Agent | Estado de cumplimiento, auditorías, dispositivos conformes o con desviaciones e infracciones |
| Security Agent | Acciones sobre dispositivos —mover, cambiar el nombre, bloquear, borrar o instalar— y clasificación de riesgos |
| Impact Agent | Análisis de solo lectura del tipo «qué pasaría si»: antes y después mediante una composición simulada de políticas |
| Policy Agent | Diseño y comparación de políticas, ajuste de prioridades y permisos de segmentos |
| Insights Agent | Análisis de la flota: tendencias, distribuciones e informes con gráficos |
| Knowledge Agent | Documentación del producto y de la API REST, con respuestas que incluyen enlaces a las fuentes |
| Enrollment Assistant | Incorporación de dispositivos: tokens de inscripción, Smart Enrollments, códigos QR y pasos para la persona que tiene el dispositivo |
| Policy Architect | Diseña y crea políticas listas para aplicar en Apple, Android, AOSP y Windows |
| Scripts Engineer | Redacta, crea y asigna scripts Bash para macOS y PowerShell para Windows |
| Vulnerability Agent | Vulnerabilidades CVE conocidas para una versión de sistema operativo o aplicación, con su gravedad, presencia en KEV y probabilidad de explotación |
Ese equipo se percibe en el uso, no solo se describe. Cada respuesta incluye una etiqueta con el nombre del especialista que la generó. Si preguntas algo que abarca varias áreas —«¿Qué dispositivos incumplen las políticas y qué podría dejar de funcionar al corregirlas?»—, el coordinador delega las tareas en paralelo y devuelve una sola respuesta. Si pides a Policy Architect una configuración base reforzada, recibes una política lista para aplicar en Apple, Android, AOSP o Windows, no una descripción. Si se lo pides a Scripts Engineer, recibes un script Bash o PowerShell que también puede asignar. En Cowork, el mismo principio funciona de forma autónoma: Posture Auditor revisa la higiene, los accesos, el inventario y la configuración y puede proponer una corrección; Threat Analyst analiza anomalías y nunca propone acciones de escritura.
La autonomía es un control gradual, no un interruptor
Este es el compromiso que importa más que cualquier capacidad descrita en esta publicación: tú decides cuánto puede ejecutarse sin tu intervención, ajuste por ajuste.
- Suggest: te informa de lo que ha encontrado y no ocurre nada más.
- Approve: prepara la corrección, identifica los objetivos y los parámetros y espera tu aprobación.
- Auto: ejecuta el procedimiento y te entrega el registro.
Puedes configurarlo por capacidad, workflow o monitor. Cámbialo cuando un tipo de tarea se haya ganado tu confianza, nunca antes. Todo comienza en Needs approval, incluidas las lecturas, porque el valor predeterminado correcto para un sistema que puede actuar sobre dispositivos en producción es pedir permiso.
Hay acciones que nunca cambian, independientemente del nivel seleccionado: el borrado, el bloqueo y cualquier acción que elimine información siempre necesitan confirmación, indicando la acción, el objetivo y los parámetros. Por debajo de todo existe una regla sin excepciones: Intelligence actúa como tú, con tu identidad y tu rol de Applivery. Si no puedes borrar un dispositivo desde el Dashboard, tampoco puedes hacerlo desde aquí. No hay una cuenta de servicio, un modo con privilegios elevados ni ninguna forma de que el asistente supere los permisos de la persona que lo utiliza.
Las medidas de seguridad se aplican en cada mensaje: filtrado de inyecciones de prompts, filtrado por alcance, bloqueo estricto de respuestas sin datos —si el Workspace no ofrece ninguna capacidad, Chat se niega a responder en lugar de inventar una flota creíble— y reglas contra la invención de información que impiden al asistente afirmar que una acción se completó si la herramienta no lo confirmó durante esa misma interacción.
API-first y ahora agent-first
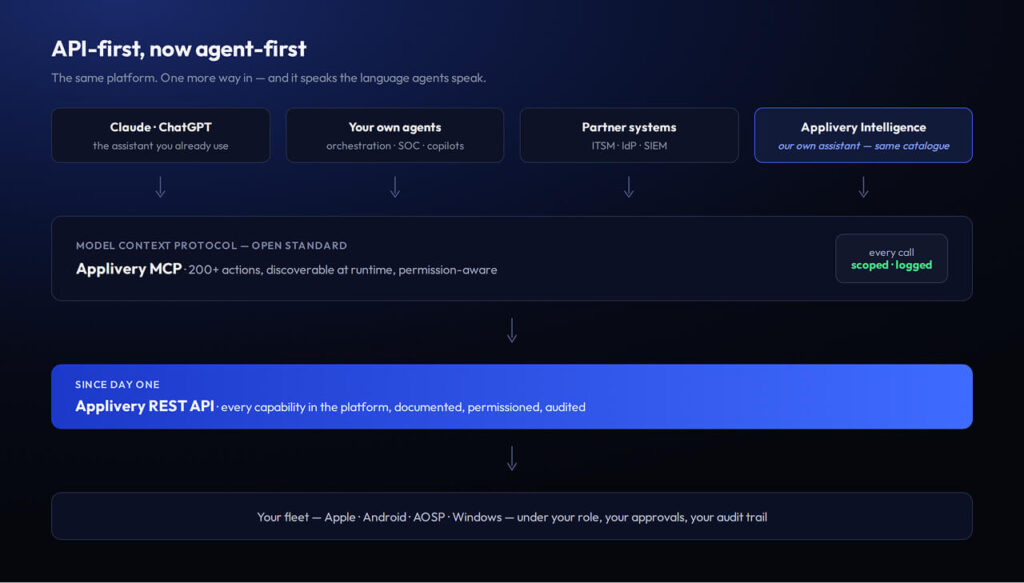
Applivery se creó con un enfoque API-first desde su primera versión. Cada capacidad de la plataforma existe como un endpoint REST documentado, con permisos y sujeto a auditoría. Creíamos que una plataforma de gestión se gana su lugar por su capacidad para integrarse con el resto de los sistemas que utiliza una empresa, no por la cantidad de trabajo que puede encerrar dentro de sus propias pantallas.
Esa decisión, tomada años antes de que alguien utilizara el término «agentic», hizo que lo siguiente fuera una continuación y no un cambio de rumbo.
Un agente de IA necesita exactamente lo mismo que necesitaba una integración: un conjunto completo de acciones que respete los permisos y una forma de descubrirlas durante la ejecución. Eso es lo que estandarizó Model Context Protocol, y el servidor MCP de Applivery es nuestra implementación: más de 200 acciones de la plataforma, detectables, limitadas por agente y con todas las llamadas registradas.
Esto tiene dos consecuencias:
- Tu flota está disponible dentro del asistente que ya utilizas. Conecta Applivery con Claude o ChatGPT y gestiona tus dispositivos desde la conversación en la que ya se encuentra el resto de tu trabajo. No necesitas generar una clave de API y se mantienen los mismos permisos y las mismas puertas de aprobación. El cambio no consiste en que una máquina pueda llamar a nuestra API. Consiste en que la persona que toma la decisión ya no tiene que entrar en nuestra consola para decidir.
- Applivery es un componente de tu arquitectura de agentes, no su punto final. Cualquier sistema compatible con MCP —tu propia orquestación, un agente de seguridad o un asistente interno— puede combinar Applivery con tu ITSM, tu proveedor de identidad y tu SIEM, de agente a agente. Como nuestra documentación y la referencia de la API también se ofrecen mediante MCP, un agente puede aprender a utilizar correctamente Applivery antes de intentarlo. Applivery Intelligence utiliza internamente ese mismo catálogo: las mismas capacidades desde un asistente diferente.
No estamos añadiendo IA a un gestor de dispositivos. Estamos creando un gestor de dispositivos que cualquier IA puede utilizar.
Hacia dónde se dirige: el Autonomous Workplace
Todo lo descrito anteriormente forma parte del producto. Esta es la dirección que seguimos, para que puedas decidir si quieres avanzar con nosotros.
El endpoint es solo el primer espacio. El mismo ciclo —supervisar, detectar, predecir, actuar y verificar— puede aplicarse a las aplicaciones, la identidad, el primer día de un empleado y el último. Estamos avanzando hacia un Autonomous Workplace: basado en el contexto, dirigido por políticas y asistido por IA. Un entorno en el que el dispositivo corporativo se configura automáticamente para la persona que lo recibe; el despliegue de una aplicación se programa de acuerdo con el estado real de la flota; el cumplimiento se mantiene entre auditorías en lugar de reconstruirse antes de cada una; y el calendario del equipo de IT deja de estar ocupado por tareas que nunca necesitaron a una persona.
El nivel de autonomía avanza al ritmo de tu confianza. Hoy, la mayoría de los equipos comenzará con Suggest, pasará las lecturas a Auto en una semana y mantendrá las acciones destructivas donde deben estar. Dentro de un año, los dos tercios rutinarios de las operaciones sobre dispositivos se ejecutarán en Auto en organizaciones que hoy no permitirían ninguna de estas acciones. No porque la tecnología se haya vuelto más atrevida, sino porque cada acción habrá dejado un registro, y los registros son la base de la confianza.
Esa es nuestra apuesta: el ganador en la gestión de dispositivos no será quien desarrolle la mejor consola. Será quien consiga que la flota sea lo bastante fiable como para funcionar por sí sola.
Planes, disponibilidad y despliegue
Applivery Intelligence está disponible de forma general y se licencia por usuario. El propietario de la organización compra usuarios de un plan y los asigna. El despliegue comienza en septiembre de 2026 y continuará progresivamente durante el cuarto trimestre, de modo que cada organización reciba la configuración y la conversación que necesita, en lugar de hacerlo todo a la vez.
| FREE | PRO | MAX | ULTRA | |
|---|---|---|---|---|
| Price | – | 29 € por usuario/mes | 99 € por usuario/mes | 199 € por usuario/mes |
| Chat | ✅ | ✅ | ✅ | ✅ |
| Insights, Workflows, Cowork | – | – | ✅ | ✅ |
| Uso por periodo | Acceso de prueba limitado | Capacidad base | 5× Pro | 10× Pro |
Los precios no incluyen IVA. Max y Ultra ofrecen las mismas funciones: la diferencia está en la capacidad, no en las prestaciones. Todos los planes utilizan los mismos modelos. Se diferencian por los espacios a los que puedes acceder y cuánto puedes utilizarlos, nunca por ofrecer a unos clientes un asistente más inteligente que a otros. Funciona en tu Workspace actual de Applivery, sobre una plataforma con certificación ISO 27001 y preparada para cumplir el RGPD en Europa.
Cómo empezar
Abre el Dashboard de Applivery y pulsa el botón ✨. Es Applivery Intelligence en tu workspace.
¿Todavía no eres cliente de Applivery? Habla con un especialista o comienza una prueba ilimitada de 14 días.